Plus loin que le seo : le manuel Linkedin pour gagner la guerre des citations par ia

On sent que quelque chose s’est déplacé.

Avant, on se battait pour un clic. Aujourd’hui, on se bat pour une place dans la réponse.

Les gens ne “cherchent” plus seulement. Ils demandent. Ils veulent une synthèse, tout de suite, sans ouvrir dix onglets. Et les modèles (ChatGPT, Claude, Perplexity…) font exactement ça : ils lisent, recoupent, puis servent une réponse prête à consommer.

Donc le vrai jeu n’est plus : être bien classé.

Le vrai jeu, c’est : être cité. Être la source qui revient naturellement quand l’IA doit justifier ce qu’elle avance.

Et ça change la manière d’écrire, de structurer, et même de mesurer.

Décoder la lisibilité ia : la structure n’est plus un détail

On a longtemps pensé que la mise en forme servait surtout aux humains.

En réalité, elle sert désormais aussi (surtout) aux machines.

Un llm ne “voit” pas votre site comme un lecteur. Il le parcourt, il le scanne, il cherche des prises. Des repères. Des blocs propres.

Si votre contenu ressemble à un pavé, il devient pénible à extraire. Et quand c’est pénible, l’ia prend ailleurs. Simplement.

Html sémantique : le squelette qui fait foi

Le html sémantique, ce n’est pas une coquetterie. C’est un langage de clarification.

h1 dit : “voici le sujet central”

h2/h3 disent : “voici les sous-idées, et leur ordre”

listes disent : “voici des points prêts à ressortir”

tableaux disent : “voici des comparaisons factuelles”

strong dit : “ce terme compte”

Quand vous structurez bien, vous réduisez l’ambiguïté.

Et une ia adore quand on lui évite d’interpréter.

Comment un llm exploite vraiment un article : le chunking

Personne ne “lit” votre article en entier côté ia.

Les modèles découpent. Ils attrapent des morceaux. Ils réutilisent des segments.

C’est froid, mais c’est utile à comprendre : votre texte doit pouvoir survivre à la découpe.

Autrement dit : chaque section doit tenir debout toute seule.

macbook pro on white bed

Règles simples pour écrire en blocs réutilisables

  • une idée par paragraphe (pas deux, pas trois)

  • la réponse au début (ensuite seulement, vous nuancez)

  • des définitions nettes (“x est y”, “x sert à y”)

  • un exemple concret dès que possible

  • zéro remplissage (les phrases “pour faire joli” coûtent cher ici)

On peut garder du style. On peut garder une voix.

Mais il faut arrêter de cacher l’information derrière des effets.

Crédibilité : l’ia ne vous “aime” pas, elle vous attribue

On vit un paradoxe assez savoureux : plus l’ia produit, plus l’humain identifiable prend de la valeur.

Un modèle va naturellement préférer ce qu’il peut attribuer :

  • un auteur clair

  • une date claire

  • un cadre clair

Pas parce qu’il a une conscience, mais parce que ça réduit le risque de se tromper.

Auteurs, dates, signaux “réels”

Un contenu signé “admin” ou “équipe marketing” ressemble à un contenu sans responsabilité.

Ça ne veut pas dire qu’il est mauvais. Juste : il est moins “ancré”.

À mettre en place (sans faire de cinéma) :

  • un auteur nommé, avec une bio courte et précise

  • une date de publication visible

  • une date de mise à jour si vous modifiez

  • du schema (author, datepublished, datemodified) pour aider l’extraction

Vous ne “faites pas du seo”. Vous rendez votre expertise attribuable.

Le ton : trop technique, vous perdez. trop léger, vous flottez.

Écrire comme un robot pour plaire au robot est une impasse.

Mais écrire uniquement pour divertir, c’est risqué aussi : la synthèse a besoin de substance.

Le meilleur point d’équilibre ressemble à ça :

  • vocabulaire simple

  • phrases qui respirent

  • précision quand il faut

  • pas de jargon gratuit

Imaginez que vous expliquez à une personne compétente, mais pressée.

Vous ne faites pas un cours. Vous livrez une réponse utilisable.

Structure qui se fait souvent citer

  • prémisse : l’idée

  • preuve : le mécanisme ou l’exemple

  • implication : ce que ça change / quoi faire

C’est sobre, mais ça marche. Et surtout, c’est facile à reprendre en synthèse.

Nouveaux kpi : ce que vous devez regarder à la place du trafic

Le trafic n’est pas “mort”. Il est juste moins central qu’avant.

Le signe qui monte, c’est la présence de votre marque dans les réponses et dans les recommandations.

La part de citation

La part de citation, c’est une question simple :

quand on interroge les ia sur votre sujet, est-ce que vous apparaissez… ou pas ?

Méthode pragmatique :

  • listez vos 20 à 50 questions les plus stratégiques (celles que vos clients se posent vraiment)

  • testez régulièrement plusieurs ia

  • notez : qui est cité, qui est recommandé, qui sert d’exemple

Ce n’est pas parfait. C’est même un peu artisanal.

Mais c’est déjà plus proche de la réalité que certains dashboards.

Bascule des métriques

  • mots-clés → prompts

  • ctr → taux de citation

  • backlinks → mentions d’entité

  • rang → présence dans la réponse

Ce changement pique l’ego, parce qu’il est binaire :

vous êtes dans la réponse, ou vous ne l’êtes pas.

Les logs : l’endroit où vous voyez les nouveaux crawlers

Si vous voulez savoir qui “passe” vraiment, regardez vos journaux serveur.

C’est moins glamour que google analytics, mais c’est plus révélateur sur ce point.

À surveiller :

  • user agents associés à des bots d’ia (selon ce que vos logs montrent)

  • fréquence de passage

  • pages visitées (quelles pages semblent “source-friendly”)

Et oui, ça pose une question inconfortable : bloquer ou laisser faire.

Bloquer protège. Laisser faire expose. Mais si votre objectif est d’être cité, l’invisibilité a un prix.

Sortir de l’entonnoir : penser influence, pas seulement acquisition

Le vieux modèle “recherche → clic → site → conversion” n’explique plus tout.

On voit de plus en plus de parcours où la décision se forme avant la visite, parfois sans visite du tout.

Votre site devient alors moins une destination, et plus un stock de connaissances structurées.

Un endroit où l’ia vient se servir pour répondre ailleurs.

Stratégie : être vu, être mentionné, être choisi

Si vous voulez être associé à votre domaine, vous devez exister là où l’ia apprend et recoupe :

  • médias d’autorité (où la confiance est déjà haute)

  • bases de connaissances factuelles (présence stable, infos propres)

  • conversations d’experts (linkedin en tête, mais pas seulement)

L’idée n’est pas “faire du bruit”.

L’idée est de créer une répétition cohérente : même sujet, même angle, même expertise, même signature.

À force, vous devenez l’association la plus naturelle.

Ce que je ferais dès cette semaine si je devais jouer cette guerre

  • reprendre les 10 contenus les plus stratégiques et les restructurer (h2/h3, listes, définitions)

  • ajouter un auteur réel, une date, et une logique de mise à jour

  • créer 20 prompts “marché” et suivre les réponses chaque mois

  • identifier 5 sources d’autorité où obtenir des mentions (pas des liens, des mentions)

  • vérifier les logs : qui visite, quoi, et à quelle fréquence

Pas besoin de tout révolutionner.

Mais il faut arrêter d’écrire comme si le clic était la seule récompense.

Parce qu’en 2026, la récompense, c’est souvent une chose très simple :

être la phrase que l’ia reprend quand quelqu’un demande “qui fait vraiment autorité là-dessus ?”.

Maîtrisez votre fil : guide analytique du trafic Google Discover

Vous pensez vraiment contrôler ce qui s’affiche sur les écrans de votre audience ? Quelle naïveté.

Dans l’écosystème numérique actuel, Google Discover n’est pas seulement un canal de trafic : c’est un miroir déformant de nos impulsions. Pendant que vous vous épuisez à optimiser vos méta-descriptions pour le Search classique comme un bon petit soldat du SEO, Discover opère ailleurs. Il propulse des sites obscurs vers la lumière… et laisse des contenus solides mourir dans l’indifférence.

C’est un flux chaotique, volatile, qui donne l’impression de récompenser le hasard plutôt que le mérite. Mais est-ce vraiment le cas ? Ou sommes-nous simplement trop confortables pour décoder la machine qui nous nourrit ?

Discover n’est pas une boîte noire : pourquoi l’analyse compte

Arrêtons de traiter Discover comme une loterie divine. Ce n’est pas de la magie, c’est de l’algorithme. Et comme tout algorithme, il laisse des traces : des empreintes que la plupart des éditeurs ignorent, préférant se plaindre de la volatilité du trafic autour d’un café à 5 CHF.

Ignorer les données Discover, c’est piloter un avion les yeux bandés. C’est accepter que votre succès dépende du bon vouloir d’une IA qui ne se soucie ni de votre marque, ni de votre chiffre d’affaires. L’analyse n’est pas un bonus : c’est votre seule arme contre l’obsolescence programmée de votre contenu.

1. L’approche “entity-first” pour performer sur Discover

Le SEO traditionnel est mort. Vive les entités.

Vous croyez encore que les mots-clés suffisent ? Google a dépassé ce stade depuis longtemps. Discover ne “lit” pas : il comprend. Il relie des personnes, des lieux, des marques, des concepts. Si votre contenu n’est pas interprétable dans le Knowledge Graph, vous n’existez pas. Vous êtes du bruit.

Cartographier votre contenu pour le Knowledge Graph

Votre article sur la crise bancaire suisse n’est pas un amas de texte pour Google. C’est une connexion entre des entités comme UBS, Credit Suisse, Zurich, finance, régulation, etc.

Si vous échouez à établir ces liens clairement, vous restez en arrière-plan. L’optimisation, ici, ce n’est pas de répéter un mot-clé jusqu’à la nausée : c’est de clarifier qui fait quoi, où, quand, et pourquoi. C’est une question d’identité, pas de sémantique.

Comment les mentions déclenchent le flux

Pourquoi un article mentionnant Roger Federer explose-t-il alors qu’une analyse tactique du tennis reste au sol ?

Parce que Federer est une entité puissante : un aimant à clics déjà “validé” par le système. Mentionner des marques, des lieux ou des personnalités reconnues, ce n’est pas du name-dropping. C’est du balisage de survie.

Vous dites à l’algorithme : “Je parle d’un sujet qui a déjà une place dans la tête de tes utilisateurs.” Cynique ? Peut-être. Efficace ? Souvent.

2. Décoder les métriques d’engagement : au-delà du clic

Le clic est la drogue du pauvre.

Regarder seulement le CTR, c’est juger la qualité d’un restaurant à la longueur de la file : séduisant, mais souvent faux. Discover ne cherche pas uniquement à capter l’attention. Il cherche à la retenir.

Si vos utilisateurs cliquent puis repartent aussitôt, vous ne “gagnez” pas. Vous vous exposez.

Le rôle de l’engagement précoce et du partage social

La viralité n’est pas un accident. Elle se construit sur un engagement rapide et fort. Les premières heures comptent.

Si personne ne partage, si personne ne réagit, Google interprète ce silence comme un signal : “Ce contenu n’a pas mérité l’espace.” La longévité sur Discover se joue parfois dans les premières minutes.

Analyser les modèles de CTR : distinguer le clickbait de l’intérêt réel

Un CTR de 15% peut sembler glorieux… mais si le temps passé sur la page est de dix secondes, vous avez perdu.

Vous avez trompé l’utilisateur, et Google n’oublie pas.

Type de CTR Comportement utilisateur Interprétation algorithmique Conséquence long terme
Explosif (>12%) Rebond immédiat (<15 sec) Titre trompeur (clickbait) Dégradation de la source
Sain (4–8%) Lecture prolongée (>1 min) Intérêt validé + satisfaction Renforcement progressif
Faible (<2%) Ignorance Sujet ou visuel non pertinent Disparition du flux

3. Signaux techniques et éligibilité Discover

Vous pouvez écrire le meilleur texte du monde : si votre technique est bancale, personne ne le lira. Le web est cruel comme ça.

Discover exige une excellence technique que beaucoup négligent — par arrogance, par fatigue ou par incompétence.

Optimisation des images : l’impact des visuels haute résolution

Discover est un produit visuel. Sans image forte, vous êtes invisible.

Google est clair : images d’au moins 1200 px de large et activation de l’aperçu large via max-image-preview:large. Ce n’est pas une “astuce”, c’est une condition de survie.

Un visuel petit, flou ou médiocre ne déclenche rien. Et sans déclencheur, pas d’impression. Sans impression, pas de clic. Sans clic… vous connaissez la suite.

E-e-a-t et autorité : pourquoi la confiance est un prérequis

Expérience, expertise, autorité, fiabilité : voilà les gardiens.

Vous pensez pouvoir saturer Discover avec du contenu IA sans supervision, sans auteur clair, sans crédibilité, sans preuves ? Bonne chance.

Discover aime ce qui rassure : une source identifiable, cohérente, régulière, légitime sur son sujet. La confiance ne s’achète pas : elle se construit. Lentement. Péniblement. Mais elle se cumule.

4. Analyse avancée : construire un vrai système de suivi

Attendre que les données tombent du ciel est une stratégie de perdant. Il faut aller les chercher, les segmenter, les comparer, et en tirer des règles exploitables.

La Search Console est votre laboratoire. Encore faut-il savoir lire autre chose que des courbes.

Exploiter le rapport Discover dans la Search Console

Le rapport Discover n’est pas là pour flatter votre ego. Il sert à identifier des patterns :

  • quels sujets reviennent (et sous quelle forme)

  • quelles pages décrochent des relances

  • quels titres/visuels déclenchent des pics

  • combien de temps durent vos “fenêtres Discover”

Si vous ne consacrez pas au moins une session hebdomadaire à disséquer ce rapport, vous ne faites pas une stratégie. Vous faites du tourisme.

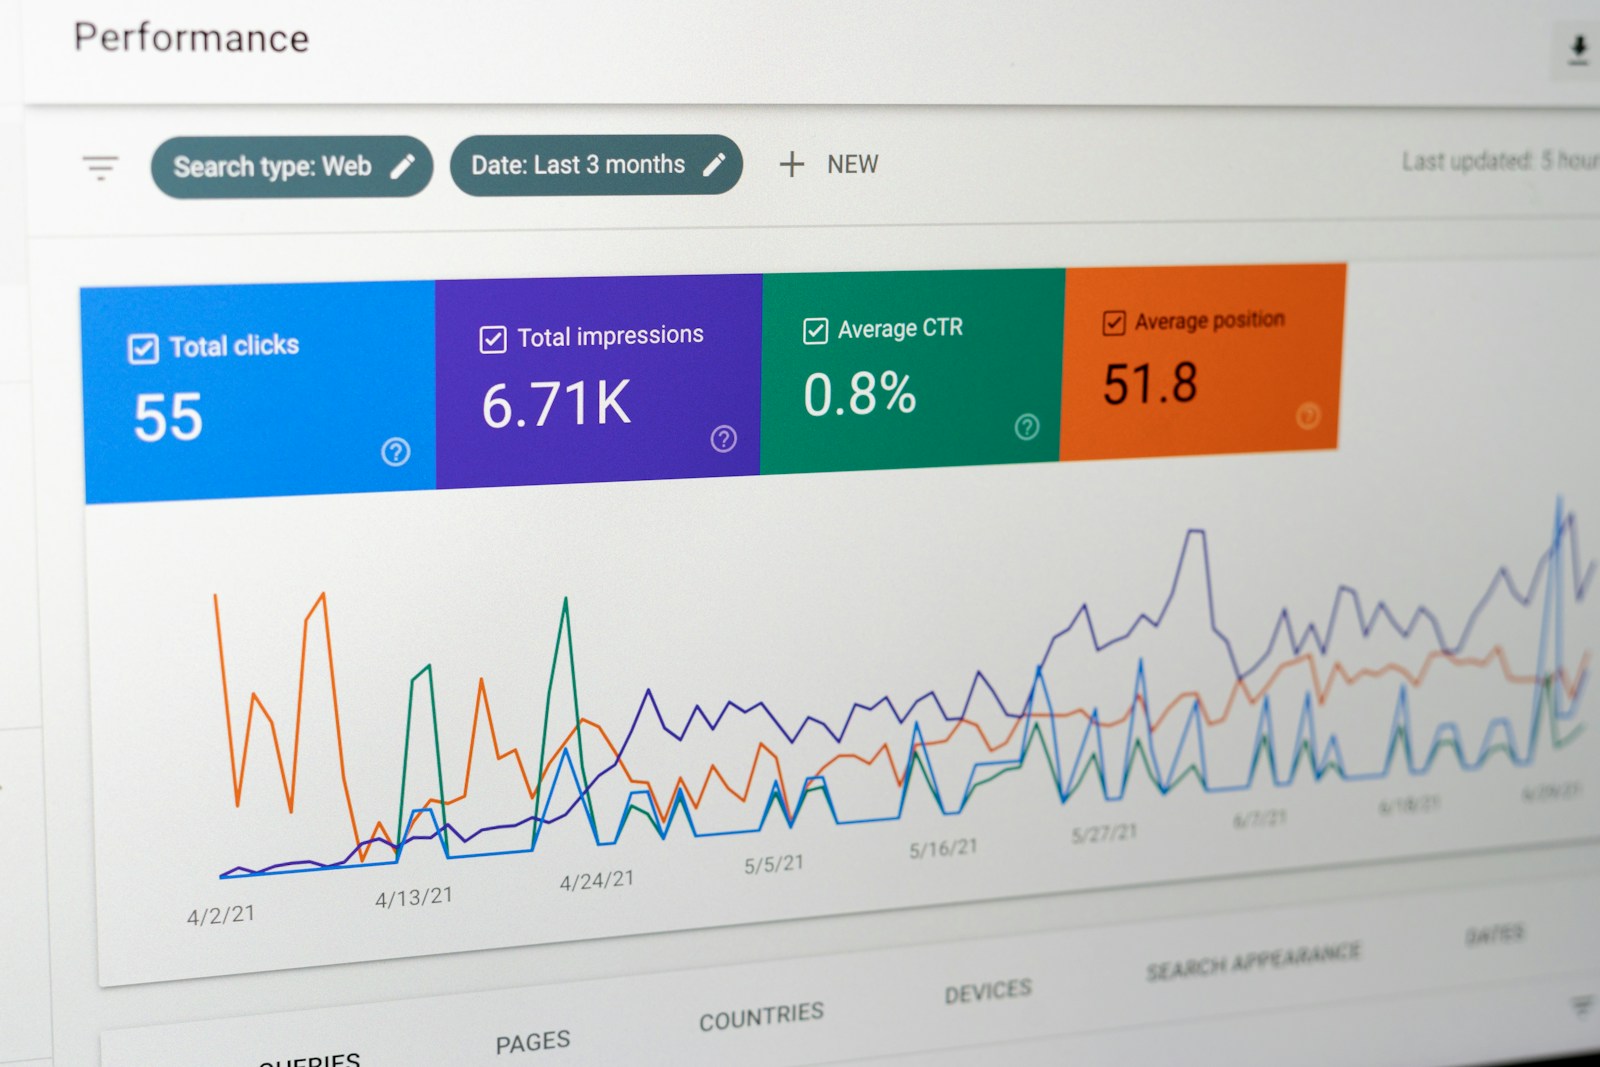
a computer screen with a bunch of data on it

Saisonnier vs tendance : classifier vos pics pour planifier

Tous les pics ne se valent pas.

Il y a le trafic saisonnier (prévisible, réutilisable), et le trafic “tendance” (rapide, brûlant, puis mort). Confondre les deux, c’est construire sur du sable.

Caractéristique Trafic saisonnier Trafic tendance (buzz)
Durée de vie Prévisible (jours/semaines) Très courte (heures/jours)
Déclencheur Calendrier (Noël, rentrée) Actualité chaude / viralité
Valeur long terme Moyenne (répétable) Faible (souvent unique)
Action requise Planification éditoriale Réactivité immédiate

5. Éviter le piège du “curiosity gap”

La tentation est grande : le titre mystérieux qui force le clic.

“Vous ne devinerez jamais ce que…” Stop. C’est pathétique. Et à moyen terme, c’est toxique.

Pourquoi les titres trompeurs tuent la crédibilité

Oui, le curiosity gap marche. Mais chaque promesse non tenue grignote votre capital confiance.

Un lecteur frustré apprend à vous éviter. L’algorithme apprend à vous déprioriser. À la fin, votre site devient un synonyme de perte de temps.

Équilibrer clic et satisfaction utilisateur

Votre titre doit être une promesse tenue, pas un piège.

Si vous promettez la lune, fournissez au moins la fusée. Sinon, restez sur Terre et faites un titre précis, utile, assumé.

Verdict : bâtir une stratégie Discover répétable

Discover n’est pas une passoire. C’est un filtre. Un filtre impitoyable qui récompense ceux qui comprennent à la fois :

  • la psychologie humaine (ce qui déclenche l’attention)

  • la mécanique algorithmique (ce qui maintient la distribution)

Arrêtez de prier pour du trafic. Commencez à analyser, structurer, et respecter vos lecteurs.

La chance n’a presque rien à voir là-dedans. C’est une guerre de l’attention, et vous ne la gagnerez pas avec des armes en plastique.

Reporting PPC moderne : les métriques que vos exécutifs veulent vraiment voir

Soyons honnêtes un instant : personne au comité de direction ne se réveille en sueur parce qu’un taux de clics a baissé de 0,5 %. Pourtant, c’est exactement le genre de bouillie numérique qu’on continue de servir dans les rapports mensuels, mois après mois.

Nous vivons une époque étrange : nous avons accès à plus de données que jamais, et pourtant nous peinons à raconter l’histoire financière de nos campagnes. Le marketing numérique s’est enfermé dans une tour d’ivoire faite d’acronymes et de graphiques qui montent vers la droite, en espérant que personne ne posera la seule question qui compte :

“Combien d’argent cela a-t-il réellement rapporté à l’entreprise ?”

Présenter des métriques de vanité à des décideurs financiers n’est pas seulement inutile, c’est dangereux. Cela décrédibilise votre travail et réduit le marketing à un centre de coûts plutôt qu’à un moteur de croissance. Il est temps de parler le langage du profit, de la marge et de l’incrémentalité.

Au-delà des métriques de vanité : pourquoi le CTR et le CPC ne suffisent plus

Le taux de clics (CTR) et le coût par clic (CPC) sont des indicateurs de santé technique. Ils sont vitaux pour le mécanicien qui règle le moteur, mais presque sans intérêt pour le conducteur qui veut juste arriver à destination.

Présenter un CPC en baisse comme une victoire à un directeur financier est une erreur stratégique… si ce CPC attire du trafic non qualifié.

Voici comment traduire vos métriques techniques en réalité business :

Ce que vous rapportez Ce qu’ils veulent savoir Pourquoi ça change tout
Clics & impressions Revenus & pipeline Le volume ne paie pas les salaires : la qualité prime.
CPC (coût par clic) CPA (coût par acquisition) Un clic “bon marché” est inutile s’il ne convertit pas.
ROAS (retour sur dépenses) Marge / profit Un ROAS élevé peut cacher une vente à perte.

1. Marge sur ROAS : le véritable bilan

Le ROAS (Return on Ad Spend) est la vache sacrée du PPC : simple, lisible, rassurant. Sauf qu’il peut mentir. Un ROAS de 500 % paraît excellent… mais si la marge produit n’est que de 15 %, vous pouvez perdre de l’argent sur chaque vente.

La réalité : le revenu brut ne suffit pas. Ce qui compte, c’est la marge de contribution — l’argent restant pour couvrir les coûts fixes une fois les coûts variables payés (produit + publicité).

Scénario comparatif :

  • Campagne A : dépense 1’000 CHF, revenu 5’000 CHF, ROAS 500 %, marge 20 % → profit réel : 0 CHF

  • Campagne B : dépense 1’000 CHF, revenu 3’000 CHF, ROAS 300 %, marge 60 % → profit réel : 800 CHF

Si vous rapportez le ROAS, la campagne A “gagne”. Si vous rapportez le profit, la campagne B est la seule qui a du sens.

2. Incrémentalité : mesurer votre véritable impact

La question qui devrait faire transpirer tout reporting superficiel :

“Ces ventes auraient-elles eu lieu sans la publicité ?”

Les plateformes publicitaires sont conçues pour s’attribuer le mérite. Si un utilisateur cherche votre marque, clique sur votre annonce et achète, Google Ads comptera une conversion… même si l’utilisateur vous cherchait déjà.

C’est la cannibalisation, fréquente en brand search et en remarketing.

L’incrémentalité mesure le lift : la différence entre les résultats avec publicité et sans publicité. Le moyen le plus crédible : des tests holdout (groupes de contrôle). Si les ventes sont identiques, vous n’achetez pas de croissance — vous achetez de l’attribution.

3. Valeur à vie (CLV) : sortir du court terme

Le court-termisme est un piège classique. Un CAC de 200 CHF pour un produit vendu 150 CHF ressemble à une catastrophe.

Mais si ce client dépense 5’000 CHF sur trois ans (abonnement, réachat, upsell), ces 200 CHF deviennent un investissement très rentable. C’est exactement le rôle de la CLV (Customer Lifetime Value).

Point clé : vous pouvez entraîner les algorithmes en important des conversions hors ligne et/ou en utilisant des règles de valeur, pour optimiser vers la valeur attendue plutôt que vers la première transaction.

4. Coût par acquisition incrémentale (CPIA) : le KPI qui évite les mauvaises décisions

Le CPA dit : “combien m’a coûté un client”.
Le CPIA dit : “combien m’a coûté un client que je n’aurais pas eu autrement”.

C’est crucial parce que :

  • la prospection (haut de funnel) a souvent un CPA plus élevé,

  • le remarketing (bas de funnel) a souvent un CPA très bas.

Si vous ne regardez que la moyenne, vous coupez la prospection… puis vous tarissez la source. Le CPIA force une lecture honnête de la croissance nette.

a person holding a piece of paper over a laptop

5. Qualité sur quantité : métriques lead-to-opportunity (B2B)

En B2B, le CPL est une métrique dangereuse. Générer 1’000 leads à 5 CHF qui sont des étudiants, des concurrents ou des curieux n’aide personne (à part à faire de jolis graphiques).

La vérité se voit dans le CRM :

L’entonnoir de vérité :

  • MQL : le formulaire est rempli

  • SQL : l’équipe commerciale confirme le potentiel

  • Opportunité : une offre est en cours

  • Client (closed-won) : revenu encaissé

Votre reporting doit remonter jusqu’au coût par opportunité et au coût par client. C’est la seule façon de justifier des CPC élevés sur des mots-clés compétitifs.

6. Délai de conversion : gérer le décalage entre dépense et revenu

Beaucoup de directions voient une dépense en mars et attendent le revenu en mars. En e-commerce, parfois. En B2B ou achats complexes, rarement.

Le conversion lag doit être expliqué et visualisé :

  • Jour 0 : premier clic (dépense engagée)

  • Jours 1–15 : recherches, comparaisons, retours

  • Jour 30 : demande de démo

  • Jour 90 : signature (revenu généré)

Couper le budget au jour 45 parce que “le ROI est mauvais” revient à tuer des ventes en maturation.

7. Contribution au pipeline et aux revenus : le reporting qui débloque des budgets

Le sommet, c’est de pouvoir dire :

“Nous avons investi 50’000 CHF ce trimestre. Cela a généré 450’000 CHF de pipeline qualifié et 150’000 CHF de revenus signés.”

Pour y arriver, il faut relier pub ↔ CRM (identifiants de clics, import de conversions offline, etc.). C’est le langage que le C-level comprend immédiatement : plus d’ambiguïté, juste une relation directe entre investissement et retour.

Métriques de diagnostic : quand regarder le CTR et le CPC

Faut-il jeter CTR et CPC ? Non. Mais ils doivent rester à leur place : le cockpit opérationnel.

Comme des voyants :

  • CPC qui explose → concurrence / enchères / saisonnalité

  • CTR qui s’effondre → fatigue créative / manque de pertinence

Ils expliquent le “pourquoi” de la performance financière. Ils ne sont pas la performance.

Pour finir : changer la culture du reporting

Passer d’un reporting “vanité” à un reporting “valeur” demande du courage. Les chiffres peuvent sembler moins flatteurs au début : un ROAS basé sur la marge est souvent plus bas qu’un ROAS basé sur le revenu brut, et un CPA incrémental est presque toujours plus élevé qu’un CPA “mélangé”.

Mais c’est le prix de la vérité.

En adoptant ces métriques, vous positionnez le marketing non comme une boîte noire, mais comme un partenaire financier fiable. Vous arrêtez de vendre des promesses et vous commencez à piloter la croissance.

5 rapports Google Analytics pour le PPC (ceux que vous devriez vraiment utiliser)

Est-ce que vous vous souvenez de l’époque où Google Analytics semblait être de votre côté ? C’était imparfait, certes, mais c’était un terrain connu. Une vieille maison de famille un peu poussiéreuse, mais dont on connaissait chaque recoin.

Puis est arrivé Google Analytics 4 (GA4). Moins une mise à jour qu’une expropriation brutale.

Ce changement forcé a contraint les marketeurs PPC à repenser non seulement où cliquer, mais comment penser. Les rapports qui trônaient fièrement au centre de votre tableau de bord sont désormais enfouis sous trois niveaux de menus obscurs. Certains nécessitent une configuration manuelle laborieuse. D’autres semblent avoir été conçus par des ingénieurs n’ayant jamais eu à justifier un budget publicitaire de leur vie.

Pourtant, on attend toujours de vous des miracles. On attend que vous expliquiez la performance, que vous justifiiez chaque euro dépensé et que vous preniez des décisions d’optimisation chirurgicales, souvent sans le luxe de pouvoir reconstruire vos rapports ou de passer des heures à déchiffrer une interface hostile.

Alors, au lieu de lutter contre la machine ou de sombrer dans la nostalgie d’Universal Analytics, soyons pragmatiques. Cet article se concentre sur cinq rapports Google Analytics qui, contre toute attente, offrent encore une valeur réelle pour le PPC. Ce sont les survivants. Ceux qui vous aident à comprendre le comportement de l’audience, à découvrir des opportunités d’expansion et à relier votre trafic payant à des résultats qui intéressent réellement votre direction.

Pourquoi Google Analytics compte encore pour le PPC en 2026

Le passage d’Universal Analytics à GA4 et ce qui a changé pour les équipes PPC

La transition vers GA4 n’était pas simplement technique ; elle était philosophique. Nous sommes passés d’un modèle basé sur les sessions — facile à comprendre, linéaire — à un modèle basé sur les événements. Tout est un événement. Un clic, une vue de page, un achat.

Pour les équipes PPC, c’est un changement de paradigme violent. L’attribution est devenue plus floue, les cookies disparaissent, et l’intelligence artificielle tente de combler les trous avec des modélisations parfois opaques. Le marketeur moderne ne peut plus se contenter de regarder le « dernier clic ». Il doit naviguer dans un écosystème où la donnée est fragmentée.

Pourquoi se concentrer sur quelques rapports à fort impact vaut mieux que de tout reconstruire

Vous pourriez passer vos semaines à essayer de recréer l’ancien monde dans le nouveau. C’est une perte de temps. L’architecture est différente.

La sagesse, dans ce chaos, consiste à identifier les quelques leviers qui fonctionnent encore. Il ne s’agit pas de tout mesurer, mais de mesurer ce qui permet de prendre une décision. Si un rapport ne vous indique pas où couper le budget ou où l’augmenter, il ne mérite pas votre attention. Les cinq rapports qui suivent passent ce test.

1. Rapport sur les audiences : transformez le comportement en ciblage

Alors que les types de correspondance de mots-clés continuent de se relâcher et que l’automatisation (Performance Max, pour ne pas la nommer) grignote votre contrôle sur la diffusion des campagnes, les signaux d’audience deviennent votre dernière ligne de défense.

Le rapport Audiences dans GA4 remplace ce sur quoi beaucoup de marketeurs s’appuyaient auparavant (les rapports basés sur les intérêts), mais avec une tournure plus pragmatique. Au lieu d’une intention supposée par Google, ce rapport est construit sur le comportement réel de l’utilisateur.

Comment les audiences basées sur le comportement surclassent les segments d’intérêt hérités

Les segments « Affinité » ou « Sur le marché » de Google sont utiles, mais ils restent des suppositions. Ce sont des corrélations probabilistes.

Une audience GA4, en revanche, est factuelle. Elle est basée sur des actions first-party : des pages vues, des événements déclenchés, des seuils d’événements clés. Pour un marketeur PPC, la valeur réside dans l’analyse d’audiences liées à des actions significatives, et non à des traits démographiques génériques dont la fiabilité est discutable.

Utilisez ce rapport pour :

  • Identifier quelles audiences génèrent réellement des conversions (désormais “événements clés”), pas juste du trafic.
  • Comparer la performance entre les convertisseurs, ceux qui consultent le panier, les visiteurs récurrents ou les utilisateurs à fort engagement.
  • Valider quelles audiences méritent des signaux plus forts (priorisation, segmentation, créas dédiées) ou une allocation budgétaire prioritaire.
  • Construire et exporter des audiences performantes directement vers Google Ads pour le remarketing.

Où trouver le rapport Audiences et quelles audiences construire en premier

Pour trouver ce rapport, naviguez vers : Rapports > Utilisateur > Attributs utilisateur > Audiences.
Note : si vous ne voyez pas “Audiences”, c’est souvent parce que le rapport n’est pas “publié” dans votre navigation (Bibliothèque / Report library). Un admin/éditeur peut l’ajouter.

Ce rapport ne sera utile que si vous avez configuré des audiences personnalisées dans GA4. Ce sont des audiences basées sur le comportement que vous définissez vous-même.

Si vous ne savez pas par où commencer, créez ces trois audiences immédiatement :

  • Les « Lèche-vitrines » : utilisateurs ayant vu plus de 3 pages produits sans ajouter au panier.
  • Les « Engagés non-convertis » : utilisateurs ayant passé plus de 2 minutes sur le site sans déclencher d’événement clé.
  • Les « Clients VIP » : utilisateurs ayant effectué plus d’un achat (si e-commerce) ou ayant soumis plusieurs formulaires.

Utiliser la performance de l’audience pour guider les enchères et les budgets

Une fois ces données en main, ne les laissez pas dormir. Si vous constatez que votre audience « Engagés non-convertis » a un taux de conversion deux fois supérieur à la moyenne lors de leur retour sur le site, c’est un signal clair.

Ensuite, adaptez l’action à votre réalité PPC : selon votre stratégie d’enchères (Smart Bidding, Performance Max, etc.), les “ajustements” directs ne s’appliquent pas toujours comme dans l’ancien monde. Mais vous pouvez :

  • prioriser ces audiences en observation/segmentation,
  • renforcer vos tests (créa/landing) sur ces profils,
  • et les exploiter en remarketing là où c’est pilotable.

2. Rapport de recherche sur site : trouvez les écarts d’intention

Le rapport de Recherche sur Site demeure l’un des outils les plus sous-utilisés pour l’expansion PPC. C’est pourtant logique : quoi de plus pur comme expression d’intention qu’un utilisateur qui tape exactement ce qu’il veut dans votre barre de recherche ?

En analysant ce que les utilisateurs recherchent une fois qu’ils atterrissent sur votre site, vous obtenez un aperçu direct des attentes non satisfaites et des lacunes d’intention.

Pourquoi les termes de recherche sur site sont une mine d’or pour l’expansion PPC

Dans GA4, les données de Recherche sur Site vivent sous le suivi des événements plutôt que dans un rapport autonome, ce qui explique pourquoi tant de gens passent à côté.

Pour les équipes PPC, ce rapport peut :

  • Informer l’expansion des mots-clés en utilisant le langage réel de l’utilisateur (souvent différent du jargon marketing).
  • Mettre en évidence des lacunes de produits ou de contenu affectant les taux de conversion.
  • Révéler des inadéquations entre le message publicitaire et les attentes sur le site.

Prenons un exemple concret. Imaginez que vous gérez un site de vente de meubles contemporains. Vos publicités vantent le « design moderne ». Pourtant, en fouillant ce rapport, vous voyez une explosion des recherches internes pour le terme « vintage » ou « industriel ».

C’est un signal d’alarme. Soit votre trafic est mal qualifié (vos pubs attirent les mauvaises personnes), soit vous avez une opportunité de produit que vous ignorez. Dans les deux cas, l’ignorance vous coûte de l’argent.

Comment accéder à la recherche sur site dans GA4 (et rendre les “search terms” visibles)

Pour trouver l’événement, naviguez vers : Rapports > Engagement > Événements
Recherchez l’événement view_search_results et cliquez dessus.

Pour voir les termes eux-mêmes, retenez ceci : l’événement existe, mais le terme (paramètre search_term) n’est pas toujours visible sans “petite mise en place”.

Deux options simples (choisissez la plus réaliste pour vous) :

  • Option A (la plus fiable) : passez par Explorations et utilisez la dimension Search term en filtrant sur view_search_results.
  • Option B (pour les rapports standards) : enregistrez search_term en tant que dimension personnalisée (portée “événement”), puis utilisez-la dans vos rapports.

Attention : ce n’est pas rétroactif, et il peut y avoir une latence (souvent 24–48h) avant de voir les données se remplir, selon votre propriété et vos paramètres.

Transformer les données de recherche interne en nouveaux mots-clés

Si vous voyez des termes récurrents dans ce rapport qui ne figurent pas dans vos campagnes Google Ads, ajoutez-les. C’est de la demande capturée, prête à être convertie.

De même, si des termes reviennent souvent mais ne mènent jamais à une conversion, c’est peut-être le moment :

  • de les ajouter en mots-clés négatifs,
  • ou de créer une page de destination spécifique pour y répondre (et arrêter de brûler du budget “à l’aveugle”).

3. Rapport sur les référents : exploitez le trafic externe de qualité

Le trafic référent est souvent ignoré par les équipes PPC, obsédées par leurs propres campagnes. C’est une occasion manquée. Pourquoi payer pour découvrir où se trouve votre audience si d’autres sites font le travail pour vous gratuitement ?

Le rapport sur les Référents montre quels sites externes envoient des utilisateurs vers votre site et comment ces utilisateurs se comportent une fois arrivés.

Identifier les sources de référence qui envoient déjà des utilisateurs qui convertissent

Pour trouver ce rapport, naviguez vers : Rapports > Acquisition > Acquisition de trafic.

Pour voir les sites web du canal Référent :

  • cliquez sur le “+” pour ajouter une dimension primaire,
  • choisissez Source/support de la session (ou “source/medium”, selon votre interface),
  • puis filtrez/recherchez referral.

Utiliser les données de référence pour tester de nouveaux placements Display et (avec nuance) Demand Gen / YouTube

Les fonctionnalités clés de ce rapport permettent de :

  • Identifier les sites tiers envoyant du trafic de haute qualité.
  • Distinguer entre les sources de référence à faible intention et celles à forte intention.
  • Construire des audiences basées sur les placements pour des tests.

Si un blog obscur sur la « permaculture urbaine » vous envoie 500 visiteurs par mois qui convertissent à 4%, c’est un signal.

Action PPC réaliste :

  • Display : utilisez ce domaine en placement (ciblage par site/app), ou comme source d’inspiration pour des placements similaires.
  • YouTube / Demand Gen : ne pensez pas “ciblage du domaine externe” (ce n’est pas le fonctionnement). Utilisez plutôt le signal comme piste pour tester des inventaires/placements sur l’écosystème Google (chaînes, contenus, audiences, exclusions), et validez via performance.

4. Rapport sur les chemins d’attribution : prouver la valeur des campagnes TOFU

En tant que marketeurs, on nous demande souvent comment performent les campagnes de haut de l’entonnoir (TOFU) ou de notoriété de la marque. La direction priorise généralement les canaux qui ont fait leurs preuves. Ils veulent s’assurer que les euros marketing sont dépensés efficacement.

Dans l’économie actuelle, c’est plus important que jamais. Mais c’est aussi un piège intellectuel. Si vous ne jugez une campagne YouTube que sur sa capacité à générer une vente directe au dernier clic, vous couperez le budget, et vos ventes Search s’effondreront trois mois plus tard.

Pourquoi le dernier clic cache le véritable impact de YouTube, Display et du social payant

Ce rapport GA4 aide à analyser et interpréter le comportement TOFU. Si vous menez n’importe quel type de campagne au-delà du Search, ce rapport est nécessaire.

Les campagnes TOFU sont critiquées pour « ne pas performer » au même rythme qu’une campagne Search. En utilisant le rapport Chemins d’attribution (anciennement “Chemins de conversion”), on obtient une vue holistique des parcours qui mènent à des événements clés et du temps nécessaire pour y arriver.

Pour trouver ce rapport, naviguez vers : Publicité > Attribution > Chemins d’attribution (ou libellé proche selon votre propriété).

Filtres et vues pour défendre le budget des campagnes de notoriété

Lorsque vous approfondissez la performance spécifique d’une campagne, je recommande :

  • Ajoutez un filtre qui contient Source/support de la session pour le canal payant spécifique en question (« google / cpc », par exemple).
  • Incluez une condition “ET” sur Campagne de la session spécifique aux campagnes TOFU en question.

Ce rapport peut révéler des données nécessaires pour soutenir la demande de budget sur les canaux TOFU. Vous découvrirez souvent que vos campagnes sociales payantes apparaissent dans une part significative des chemins d’attribution, mais surtout au début du voyage. Sans elles, le voyage ne commence jamais.

5. Rapport sur les événements clés : au-delà de la conversion unique

La plupart des comptes PPC optimisent vers une seule conversion primaire. Cela a du sens pour les enchères automatiques, mais cela raconte rarement l’histoire complète de la façon dont le trafic payant contribue réellement aux revenus.

Le rapport sur les événements clés (l’ancienne logique “conversions”) vous permet de prendre du recul et d’évaluer toutes les actions significatives que les utilisateurs entreprennent, pas seulement la dernière qui obtient le crédit dans la plateforme.

rapports GA4

Cartographier l’entonnoir complet des actions significatives

Pour la prise de décision PPC, ce rapport aide à répondre à des questions que Google Ads seul ne peut pas, telles que :

  • Quelles actions se produisent systématiquement avant un achat ou une soumission de lead (téléchargement de PDF, vue de la page tarifs).
  • Si certaines campagnes génèrent une forte intention mais échouent à conclure immédiatement.
  • Comment différents canaux payants influencent l’engagement précoce par rapport à la conversion finale.

Cela devient particulièrement important lors de l’évaluation de campagnes Display, YouTube, Demand Gen ou sociales payantes. Ces campagnes semblent souvent inefficaces jugées uniquement au dernier clic, mais elles peuvent générer des actions clés : vues de produits, visites de la page de tarification, débuts de formulaire, sessions répétées, etc.

Diagnostiquer les points de chute

Pour trouver ce rapport (base), naviguez vers : Rapports > Engagement > Événements.
Ensuite, focalisez-vous sur les événements que vous avez explicitement marqués comme événements clés dans l’admin. La précision commence par une configuration d’événements propre.

Une autre utilisation pratique est de diagnostiquer les points de chute. Si une campagne génère des volumes élevés d’événements précoces (comme « add_to_cart ») mais peine à générer des événements finaux (« purchase »), le problème peut résider dans l’expérience de la page de destination, la friction du checkout/formulaire ou le timing du suivi — plutôt que dans le ciblage ou les enchères.

Transformer les insights GA4 en meilleures décisions PPC

Google Analytics n’est pas l’endroit où la plupart des optimisations PPC se produisent au jour le jour. Ce travail vit toujours à l’intérieur des plateformes publicitaires. Et c’est tant mieux, car l’interface de GA4 n’est pas faite pour la rapidité.

Mais ces rapports servent un objectif différent. Ils aident les gestionnaires PPC à prendre du recul et à comprendre comment le trafic payant se comporte une fois qu’il atteint le site, comment les utilisateurs se déplacent à travers les canaux, et quelles actions signalent réellement l’intention.

Utilisés mensuellement ou trimestriellement, ces rapports font surface des modèles que les revues de compte quotidiennes manquent souvent. Ils soutiennent des décisions de ciblage plus intelligentes, des explications de performance plus claires et des conversations budgétaires plus confiantes.

Lorsque vous vous concentrez sur les rapports qui répondent constamment à de vraies questions PPC, Google Analytics devient moins une corvée administrative et plus un atout stratégique. Ou du moins, un mal nécessaire un peu plus supportable.


Le commerce agentique : Comment survivre quand les algorithmes font le shopping ?

Soyons honnêtes un instant. Le marketing tel que nous l’avons connu — cette douce illusion où une jolie page de destination et quelques mots-clés bien placés suffisaient à masquer la médiocrité d’un produit — est en train d’agoniser. Nous entrons dans une ère froide, clinique et impitoyable.
Bienvenue dans le commerce agentique.

Les chiffres ne mentent pas, même s’ils sont terrifiants pour quiconque s’accroche au passé. Durant la saison des fêtes 2025, selon les données publiées par Salesforce, l’IA et les agents ont “propulsé” environ 20 % des ventes au détail. Ce n’est plus une curiosité, c’est un changement de régime. L’IA transforme la recherche organique : elle n’est plus une source de trafic bon marché, elle devient un gardien de la vérification. L’arbitrage marketing perd du terrain ; la vérité produit devient décisive.

Alors, comment comptez-vous rivaliser quand l’utilisateur ne clique même plus sur votre site web pour acheter ?

Comprendre l’essor du commerce agentique

Le terme est sur toutes les lèvres, mais peu saisissent la violence du changement qu’il implique. Nous ne parlons pas simplement d’un chatbot qui suggère un pull en laine.

Ce que signifie vraiment « agentique » dans les marchés pilotés par l’IA

L’agentique agit comme un « grand filtre ». Jusqu’à présent, Internet permettait à beaucoup de marques blanches de prospérer grâce à l’arbitrage publicitaire. Mais les grands modèles de langage (LLM) sont des lecteurs de données dépassionnés. Ils ne sont pas séduits par votre image de marque léchée ; ils tendent à privilégier des spécifications vérifiables, comparables, cohérentes. Si votre produit est identique à une alternative générique mais coûte deux fois plus cher, l’agent aura tendance à ne pas le recommander — sauf signal fort (marque, confiance, disponibilité, logistique).

Comment les agents d’achat autonomes redéfinissent l’e-commerce

L’infrastructure se met déjà en place. ChatGPT propose l’Instant Checkout (basé sur l’Agentic Commerce Protocol). Microsoft Copilot pousse Copilot Checkout et s’appuie sur l’ACP pour standardiser certains échanges commerciaux (catalogue/checkout). Google pousse l’UCP (Universal Commerce Protocol) pour permettre des parcours d’achat agentiques dans ses surfaces (Search, Gemini/AI Mode…).

La question stratégique qui demeure est brutale : où se situe la valeur ? L’achat autonome total (donner une carte de crédit à une IA pour qu’elle vive votre vie) reste très limité pour l’instant. Les achats à haut risque (voiture, billets d’avion) sont plus sensibles et exigent validation, contraintes et garde-fous. Les achats à faible risque (papier toilette) sont déjà automatisés par abonnement.

La révolution se joue au milieu : la compression de l’entonnoir. Au lieu de passer par une longue séquence d’interactions, les LLM réduisent parfois le parcours à une ou deux interactions. Ils lisent les avis d’experts, les listes d’ingrédients et les retours utilisateurs pour vous.

Pourquoi le commerce agentique change les règles de la concurrence

Nous passons d’un monde d’espace infini (10 liens bleus, pagination sans fin) à un monde d’espace restreint (quelques recommandations dans une réponse IA).

De l’intention utilisateur à la décision de l’agent

Les nouveaux protocoles rendent le commerce « headless » (sans tête). Votre site web devient moins important en tant que destination visuelle et crucial en tant que base de données structurée.
Le jeu ne consiste plus à optimiser le design pour l’œil humain, mais à optimiser les flux de données pour l’ingestion par la machine. Si votre stock, votre vitesse d’expédition ou votre politique de retour ne sont pas accessibles via API (ou via un flux exploitable), vous devenez beaucoup moins éligible pour l’agent. Vous risquez tout simplement de ne pas exister dans sa sélection.

Comment la confiance, les données et la personnalisation deviennent les champs de bataille

C’est la fin des marques marketing sans substance. Si vous prétendez être la « meilleure chaussure de course pour pieds plats », le modèle ne cherche pas d’adjectifs. Il tente de comparer vos données à des références techniques connues, à des signaux externes et à un consensus.

Votre contenu doit passer de l’engagement général à la « Vérité Produit ». Les LLM peuvent privilégier les tableaux comparatifs détaillés, les résultats de tests propriétaires, les compositions/ingrédients — selon la catégorie. Si vos données ne sont pas structurées pour une vérification facile, le modèle vous contournera pour une source qui l’est.

Le nouveau paysage concurrentiel en 2026

Le passage de la recherche à la conversation crée un ensemble distinct de gagnants, de perdants et de dilemmes stratégiques. C’est un jeu à somme nulle.

Plateformes contre écosystèmes produits

Vous allez devoir choisir votre poison entre deux visions du monde :

  • L’ACP d’OpenAI (Le Jardin Clos) : OpenAI traite les marchands comme des fournisseurs. Vous gagnez l’accès à des centaines de millions d’utilisateurs, mais vous risquez de perdre une partie de la relation client directe (donc une partie de la valeur post-achat : CRM, retargeting, upsell, fidélisation).
  • L’UCP de Google (La Couche Distribuée) : Google étend son Shopping Graph et ses surfaces IA. Vous pouvez davantage garder le client et la donnée. Le coût ? Une intensité concurrentielle infernale. Au lieu de vous battre pour 10 liens, vous vous battez pour l’un des quelques “slots” dans un aperçu IA. La marge d’erreur dans vos données produit est très faible.

Le rôle des API, de l’interopérabilité et des partenariats IA

Ce changement perturbe tout l’écosystème. Les affiliés subissent une pression massive : si un assistant synthétise les avis sans envoyer de trafic, l’économie du clic se reconfigure.

Même Amazon est face à un conflit de modèle économique. Leurs marges de détail sont minces ; leurs profits viennent largement d’activités plus “services” — et leurs revenus publicitaires (retail media) se comptent en dizaines de milliards (autour de 60 milliards). Mais leur machine publicitaire repose sur un parcours multi-étapes riche en surfaces sponsorisées. Si le commerce conversationnel compresse cela drastiquement, l’inventaire des produits sponsorisés se réduit. Amazon doit arbitrer entre contrôle, ouverture et intégration, sans cannibaliser trop vite ses propres revenus.

 marketing

Comment les marques peuvent rester pertinentes quand les agents achètent pour les utilisateurs

Dans cet environnement, le SEO change de nature. L’objectif n’est plus d’amener un humain sur votre page, mais de faire entrer vos données produit dans la fenêtre contextuelle de l’agent avec suffisamment d’autorité pour qu’il vous recommande.

Construire une identité de marque lisible par la machine

Le nouveau « SEO Technique » n’est plus la vitesse du site, c’est l’intégrité du flux. Les agents ne « naviguent » pas sur votre site ; ils interrogent votre API, vos feeds, vos surfaces structurées.

Le nouveau « SEO On-Page » exige un Gain d’Information. Les LLM sont entraînés sur le consensus. Pour être cité, vous devez fournir le delta entre ce que le modèle sait déjà et la valeur unique que vous apportez : des données propriétaires, des tests exclusifs, des faits bruts.

Gagner la « confiance de l’agent » grâce à des données transparentes et des signaux fiables

Le « SEO Off-Page » évolue aussi. Les backlinks importent toujours, mais comme sources de vérification pour la synthèse de réputation. Un volume élevé d’avis vérifiés et spécifiques sur des plateformes tierces de confiance (forums spécialisés, communautés, plateformes d’avis…) peut devenir un signal très fort. Les modèles agrègent ces signaux publics pour former un consensus.

Stratégies pour survivre sur les marchés agentiques

Alors, que faire ? Se coucher et attendre la faillite ? Ou s’adapter à cette réalité dystopique ?

Optimiser les données produits pour la découverte par LLM

Votre flux marchand est votre vitrine principale. Il doit être impeccable. Chaque attribut, chaque spécification, chaque nuance de votre produit doit être codé et accessible. Oubliez le blabla marketing. Donnez aux machines de la donnée brute, structurée, dense.

Créer des boucles de rétroaction avec l’analyse des agents

Les agents ont souvent un biais de sécurité : ils tendent à préférer le consensus pour limiter les erreurs. Une marque de niche ressemble à du bruit ; un leader de catégorie ressemble à la vérité. L’un des rares leviers qui peut contrebalancer ce biais est la donnée granulaire : sourcing exact, analyses précises, résultats de tests, preuves que les géants ne publient pas.

Tirer parti des micro-incitations et des protocoles de fidélité pour les agents IA

Dans un monde où une IA suggère quelques options, la familiarité de la marque devient un facteur décisif — à ce stade, l’agent filtre surtout par données et fiabilité, mais l’humain tranche souvent par reconnaissance. La publicité de marque et la construction organique de marque redeviennent un levier critique pour s’assurer que l’utilisateur (l’humain, en fin de compte) reconnaisse la recommandation fournie par l’IA.

Outils émergents et normes à surveiller

Ne soyez pas naïfs. Ce n’est pas le futur, c’est le présent.

Plateformes de commerce agentique (OpenAI, Amazon, écosystèmes Shopify)

Les alliances se forment. Microsoft active des parcours marchands avec des partenaires majeurs. Google pousse son standard. Vous devez choisir vos batailles et décider quels protocoles intégrer en priorité. Ignorer l’un ou l’autre, c’est se couper d’une partie du marché.

Protocoles façonnant les transactions d’agent à agent

Surveillez de près l’évolution de l’ACP et de l’UCP. Ces protocoles détermineront qui possède la donnée, qui possède le client, et in fine, qui survit. La guerre des standards ne fait que commencer.

L’avantage de la marque humaine

Peut-être est-ce là l’ironie suprême de notre époque. À mesure que nous nous enfonçons dans l’automatisation, l’humain devient le seul luxe véritable.

Storytelling et authenticité dans un marché automatisé

Les algorithmes convergent vers l’efficacité. Ils lissent tout. Ils rendent tout moyen. Pour vous différencier, vous devez être radicalement humain. Votre histoire, vos échecs, votre mission — ce sont des données que l’IA peut traiter, mais qu’elle ne peut pas (encore) falsifier avec âme.

Utiliser la créativité humaine pour se différencier là où les algorithmes convergent

L’IA est excellente pour donner la réponse moyenne à une question moyenne. Elle est médiocre pour l’exceptionnel. Votre survie dépend de votre capacité à être l’exception, l’anomalie statistique que l’agent ne peut ignorer.

Pensées finales — Survivre à l’âge des acheteurs intelligents

Le commerce agentique n’est pas une opportunité pour tous. C’est un purificateur. Il va éliminer les intermédiaires inutiles, les produits médiocres et les marketeurs paresseux.

La recherche organique ne sert plus seulement à obtenir des clics ; c’est un prérequis pour la vérification agentique. Si vous n’êtes pas capable de prouver de manière vérifiable à une machine que votre produit est supérieur, vous n’aurez peut-être même pas la chance d’essayer de convaincre un humain.

Le monde change. Adaptez-vous, ou disparaissez.

Les tendances qui façonneront l’IA et la tech en 2026 (pour le meilleur ou pour le pire)

L’année technologique file à une allure qui donne la nausée. Si vous avez trouvé 2025 épuisante, préparez-vous : 2026 s’annonce comme une course effrénée vers un horizon que nous distinguons à peine. C’est le paradoxe de notre époque : nous n’avons jamais couru aussi vite, mais savons-nous seulement où nous allons ?

L’innovation ne ralentit pas. Elle s’accélère, indifférente à notre essoufflement collectif. Des puces toujours plus puissantes, des modèles qui raisonnent, des agents qui agissent à notre place… Tout cela est présenté sous le vernis brillant du progrès inéluctable. Mais grattez un peu la surface, et vous trouverez des questions vertigineuses sur notre propre utilité, notre souveraineté et notre capacité à distinguer le vrai du faux.

Inspirés par les prédictions des experts d’IBM et les soubresauts de l’industrie, voici les tendances qui vont redéfinir notre réalité en 2026. Regardez-les bien en face. C’est le monde que nous avons construit.

Du quantique à l’efficience : La nouvelle frontière du calcul

Nous avons atteint un mur. La loi de Moore s’essouffle, et la voracité énergétique de nos centres de données commence à faire passer l’industrie pétrolière pour un modèle d’écologie. La réponse de la tech ? Fuir vers l’avant, vers de nouvelles physiques et de nouvelles contraintes.

L’informatique quantique atteint sa suprématie classique

C’est une promesse que l’on nous agite sous le nez depuis des décennies, comme une carotte devant un âne numérique. Mais selon Jamie Garcia d’IBM, 2026 marquera le point de bascule. Pour la première fois, un ordinateur quantique sera capable de surpasser un ordinateur classique sur une tâche utile.

Ce n’est plus de la science-fiction, c’est de l’ingénierie. Nous allons voir émerger des percées dans le développement de médicaments ou l’optimisation financière. Mais ne nous y trompons pas : en créant des machines capables de calculs qui dépassent l’entendement humain, nous abdiquons une part supplémentaire de notre compréhension du monde. Nous confions les clés de la réalité à des qubits instables, espérant qu’ils seront plus sages que nous.

Le matériel efficient devient la nouvelle stratégie de mise à l’échelle

Fini le temps de l’abondance insouciante où l’on pouvait simplement ajouter des GPU pour masquer l’inefficacité du code. Kaoutar El Maghraoui, scientifique chez IBM, prévient : 2026 sera l’année de l’efficience. La pénurie de puces et la demande énergétique forcent l’industrie à la sobriété.

Ce n’est pas par vertu écologique, rassurez-vous, mais par pure nécessité économique. Nous allons voir une diversification du matériel : des accélérateurs ASIC, des puces analogiques, peut-être même de nouveaux processeurs dédiés aux agents. L’ironie est mordante : c’est au moment où la ressource manque que nous devenons intelligents.

Au-delà des modèles : L’avènement des systèmes et des agents

L’obsession pour le « plus gros modèle » est passée. C’était la mode de 2024. Désormais, le modèle brut est une commodité, un ingrédient de base sans saveur. La valeur se déplace vers ceux qui savent cuisiner.

Les systèmes, et non les modèles, définiront le leadership

Gabe Goodhart le dit sans détour : le modèle lui-même ne sera plus le différenciateur principal. Ce qui compte, c’est l’orchestration. C’est la capacité à combiner des outils, des flux de travail et des modèles pour créer un système cohérent.

Pensez-y : nous construisons des bureaucraties numériques. ChatGPT n’est plus juste un chatbot, c’est un système tentaculaire qui navigue sur le web, exécute du code et gère des tâches. Nous allons vers un « routage coopératif » où de petits modèles délèguent aux plus gros. Une hiérarchie corporate, mais faite de silicium.

Le parsing agentique remplace le traitement documentaire monolithique

C’est peut-être la tendance la plus ennuyeuse en apparence, et pourtant la plus révélatrice. Brian Raymond, CEO d’Unstructured, décrit la fin du traitement de document classique. Place au « parsing agentique ».

Nous allons découper nos documents, nos savoirs, nos écrits, pour les donner en pâture à des agents spécialisés qui vont scanner, indexer et construire des graphes sémantiques. Nous transformons notre culture écrite en base de données pour machines. L’objectif ? Des systèmes de données d’entreprise « conscients d’eux-mêmes ». Si l’idée d’un fichier Excel conscient d’el-même ne vous effraie pas, rien ne le fera.

L’émergence des « super agents » et des tableaux de bord multi-agents

Chris Hay prédit l’arrivée des « super agents » capables d’opérer à travers votre navigateur, votre éditeur de code et votre boîte mail. Plus besoin de jongler avec dix outils ; l’agent le fait pour vous.

C’est la promesse de la facilité ultime. Mais c’est aussi celle de l’assistanat total. En déléguant l’interface à la machine, nous perdons le contact direct avec l’outil. Nous devenons les superviseurs passifs d’une activité frénétique qui nous échappe.

L’orchestration des flux de travail et la démocratisation

Selon Kevin Chung de Writer, l’IA passe de l’usage individuel à l’orchestration d’équipe. Pire encore (ou mieux, selon votre niveau de cynisme), la création d’agents se démocratise.

« Chaque utilisateur devient un compositeur d’IA ». La phrase est belle, mais la réalité risque d’être cacophonique. Des milliers de « business users » créant leurs propres agents pour automatiser leurs tâches, sans supervision, sans standard. C’est le chaos administratif élevé au rang d’art.

Du « Vibe Coding » au protocole objectif-validation

En 2025, on s’amusait avec le « vibe coding » — on demandait à l’IA de coder au feeling. C’était mignon. Ismael Faro d’IBM Research annonce la fin de la récréation. Place au « Protocole Objectif-Validation ».

Les ingénieurs ne coderont plus ; ils définiront des objectifs et valideront le travail des agents autonomes. C’est l’industrialisation du développement logiciel. L’humain n’est plus l’artisan, il est l’inspecteur des travaux finis. Une perte de savoir-faire au profit de la productivité ? Sans doute.

L’IA multimodale percevra le monde comme les humains

Les modèles génératifs ne se contentent plus de lire. Ils voient, ils entendent, ils ressentent presque. Aaron Baughman décrit des travailleurs numériques multimodaux capables d’interpréter des cas médicaux complexes ou des événements sportifs en temps réel.

La machine acquiert des sens. Elle interprète le monde non plus comme une base de données, mais comme une expérience sensorielle. Elle commence à empiéter sur le dernier bastion de l’humanité : l’interprétation subjective de la réalité.

Les protocoles multi-agents passent en production

C’est ici que ça devient vraiment intéressant. Kate Blair souligne que 2026 verra la généralisation de la communication agent-à-agent (A2A). Les protocoles comme le MCP (Model Context Protocol) d’Anthropic ou l’A2A de Google permettent aux agents de se parler, de négocier et de collaborer.

Ils se parlent entre eux. Dans un langage standardisé. Pour exécuter des tâches que nous leur avons vaguement assignées. Nous construisons une société parallèle d’entités numériques qui collaborent dans l’ombre de nos serveurs. Espérons qu’ils ne décident pas de se syndiquer.

L’IA d’entreprise, réinventée (et verrouillée)

L’époque des expérimentations joyeuses est révolue. Les entreprises veulent du retour sur investissement (ROI). Et pour cela, elles sont prêtes à tout verrouiller.

Des déploiements privés et sécurisés avec un vrai ROI

David Lanstein d’Atolio est clair : fini le jeu. Les entreprises exigent désormais des déploiements privés, sécurisés, avec un ROI tangible. Les fuites de données ont érodé la confiance.

On ne parle plus de magie, mais de « souveraineté des données » et de « permissioning ». L’IA d’entreprise devient une forteresse. C’est la fin de l’innocence et le début de la bureaucratie algorithmique sécurisée.

La gestion des identités non-humaines

C’est une statistique qui fait froid dans le dos, relayée par DTEX et Shlomi Yanai : les identités non-humaines (bots, agents, comptes de service) surpassent désormais largement les humains dans l’entreprise. On parle d’un ratio de 20 pour 1.

Qui travaille pour qui ? Dans une organisation où 95% des « employés » sont des scripts et des agents IA, l’humain devient une minorité à gérer. La cybersécurité doit se réinventer pour surveiller cette armée de l’ombre qui ne dort jamais.

L’automatisation machine devient réalité

Steven Aberle de Rohirrim prévoit que l’IA va s’attaquer aux flux de travail complexes de bout en bout. Elle ne se contente plus de répondre à des questions ; elle influence directement les résultats.

Dans les départements d’achats ou de logistique, l’IA traque les besoins, repère les manques et suggère des corrections. Elle prend les rênes. L’humain est relégué au rang de validateur occasionnel, un simple tampon de caoutchouc sur des décisions prises à la vitesse de la lumière.

L’Open Source et la fragmentation du futur

Pendant que les géants ferment leurs modèles, la résistance s’organise en ordre dispersé.

Diversification et modèles plus petits à la périphérie (Edge)

Matt White de la PyTorch Foundation note que les petits modèles optimisés pour des domaines spécifiques deviennent centraux. Pourquoi ? Pour le coût, la latence et la souveraineté.

L’IA quitte le cloud pour envahir nos appareils périphériques. Votre téléphone, votre voiture, votre frigo. L’intelligence est partout, diffuse, omniprésente. Il n’y a plus de refuge hors ligne.

La robotique et l’IA physique comme nouvelle frontière

Peter Staar d’IBM Research Zurich fait un constat amer : l’industrie atteint les rendements décroissants des LLM. On s’ennuie. Alors, on se tourne vers la robotique.

L’IA doit sentir, agir et apprendre dans le monde réel. C’est le moment où l’esprit numérique cherche un corps. NVIDIA pousse l’écosystème, et nous nous préparons à voir nos usines et nos rues peuplées d’entités autonomes.

Des modèles spécifiques au domaine plutôt que des géants

Anthony Annunziata prédit la fin du règne des modèles généralistes titanesques. L’avenir est aux modèles de raisonnement plus petits, multimodaux et hyper-spécialisés.

C’est la fin de l’illusion de l’IA omnisciente. Nous retournons à une forme de spécialisation du travail, mais appliquée aux neurones artificiels. C’est plus efficace, certes, mais cela fragmente encore un peu plus le paysage technologique.

Les systèmes d’IA de qualité production en entreprise

Tomás Hernando Kofman de Not Diamond voit émerger des réseaux décentralisés d’agents qui apprennent les uns des autres. Ils partagent l’information et retiennent la connaissance sur de longs horizons.

C’est une mémoire collective artificielle qui se construit, indépendante de la mémoire humaine. Une culture machine qui se transmet d’agent à agent, sans que nous ayons besoin d’intervenir.

Tendances IA

La confiance comme stratégie (ou comme ligne Maginot)

Dans ce monde de faussaires numériques, la confiance devient la denrée la plus rare et la plus chère.

Défense en profondeur contre les Deepfakes

Ben Colman de Reality Defender nous avertit : aucune entité seule ne peut résoudre la crise des deepfakes et de l’IA militarisée. Il faut une « défense en profondeur », une superposition de boucliers.

Nous en sommes là : obligés de déployer des IA pour surveiller d’autres IA, pour nous dire si ce que nous voyons est réel. La réalité est devenue une zone de guerre, et la vérité une victime collatérale.

La souveraineté de l’IA comme mission critique

Enfin, Anthony Marshall de l’IBM Institute for Business Value lâche le chiffre : 93% des dirigeants considèrent la souveraineté de l’IA comme indispensable.

Face à l’instabilité géopolitique, personne ne veut dépendre d’un cloud étranger. C’est le retour des frontières, mais numériques. Chaque bloc, chaque nation, chaque entreprise veut son propre cerveau, ses propres données, sa propre vérité. La fragmentation du web est actée ; celle de l’intelligence commence.

En 2026, nous ne ferons pas que « d’utiliser » la technologie. Nous vivrons dans ses interstices, gérant tant bien que mal une complexité qui nous dépasse, surveillés par des agents que nous avons nous-mêmes programmés. C’est un monde d’efficience redoutable, où l’humain doit lutter pour justifier sa place dans la boucle. Bonne année à tous.

Le SEO Local est mort : Comment survivre à l’apocalypse du « AI Mode » de Google ?

Regardez autour de vous. Le paysage numérique que vous connaissiez, ce bon vieux système de liens bleus ordonnés et rassurants, est en train de s’effondrer. Google n’est plus un moteur de recherche. C’est devenu une machine à réponses, un oracle numérique qui cannibalise votre contenu pour le recracher sous une forme synthétisée, vous privant du clic que vous avez passé des années à mériter.

C’est brutal, n’est-ce pas ? Mais c’est la réalité. Avec l’avènement des « AI Overviews » et du nouveau « AI Mode », nous n’assistons pas à une simple mise à jour d’algorithme. C’est un changement de régime. Une refonte totale des règles du jeu où le gagnant rafle tout, et où les perdants disparaissent dans les limbes de la deuxième page.

Pour les entreprises locales, l’enjeu est existentiel. La question n’est plus de savoir comment se classer premier, mais comment exister aux yeux d’une intelligence artificielle qui prétend tout savoir sur vous. Êtes-vous prêt à sacrifier vos vieilles habitudes SEO sur l’autel de la modernité ?

Le changement de paradigme : Des liens bleus au « AI Mode »

Il fut un temps où le contrat était simple : vous donniez de l’information, Google vous envoyait du trafic. Ce temps est révolu. L’intégration de l’IA générative dans la recherche est une rupture fondamentale. Nous passons d’un environnement de sélection (je clique sur un lien) à un environnement conversationnel (je discute avec la machine).

Les AI Overviews s’emparent du haut de la SERP, l’AI Mode trace le parcours complet

La première vague de ce tsunami a été l’AI Overview (AIO), cette réponse générée qui s’installe au-dessus des résultats organiques. Mais le véritable danger, c’est l’AI Mode. C’est un écosystème conversationnel complet où l’utilisateur n’a plus besoin de vous. L’IA anticipe ses besoins, devine ses prochaines questions (le fameux « query fan-out ») et lui sert tout sur un plateau d’argent. Pourquoi l’utilisateur cliquerait-il sur votre site quand Google lui mâche le travail ?

Une chute d’environ 61% du CTR quand l’IA capte l’attention (et que vous n’êtes pas dans la synthèse)

Les chiffres sont là, et ils sont effrayants. D’après une analyse de Seer Interactive, sur un échantillon de requêtes où les AI Overviews sont présents, le taux de clic organique a pu chuter fortement (jusqu’à ~61% sur la période étudiée). Et lorsque votre site n’est pas cité dans l’overview, l’érosion est souvent plus douloureuse : vous n’êtes pas seulement ignoré ; vous devenez invisible.

Le succès ne se mesure plus uniquement en positionnement classique, mais en probabilité d’être inclus dans cette synthèse artificielle — ou, à défaut, en capacité à convertir le trafic raréfié qui survit.

Les cartes GBP peuvent supplanter ou reléguer les « Local Packs » traditionnels

Pour les recherches locales, le coup de grâce vient de la transformation progressive des surfaces locales : le « Local Pack » (le fameux trio) n’est plus garanti comme point d’entrée dominant. Selon les requêtes, les marchés et les appareils, il peut être remplacé, intégré, ou simplement repoussé par des formats enrichis (dont des cartes Google Business Profile) plus étroitement reliés aux expériences IA.

L’utilisateur cherche le « meilleur plombier » ? L’IA ne lui donne pas forcément une liste ; elle lui donne une réponse argumentée, basée sur une sélection impitoyable d’entités qu’elle juge dignes de confiance.

L’autorité de l’entité écrase le SEO traditionnel

Oubliez vos campagnes de netlinking automatisées et vos mots-clés bourrés au chausse-pied. Dans ce nouveau monde, l’IA se moque de vos astuces techniques. Elle cherche la vérité, ou du moins, ce qu’elle considère comme la vérité.

L’IA puise dans des sources omnicanales, pas juste les sites web

L’IA fonctionne comme un enquêteur paranoïaque. Elle ne croit pas ce que vous dites sur votre site. Elle vérifie tout. Elle croise les données de votre site avec vos réseaux sociaux, les annuaires, les articles de presse, et les avis clients. C’est l’ère de « l’Entity Authority ». L’écosystème numérique tout entier devient votre vecteur de classement. Si vous êtes incohérent, vous êtes suspect. Et si vous êtes suspect, vous êtes exclu.

Environ 57% des requêtes locales peuvent déclencher des AI Overviews (selon les tests)

C’est une invasion silencieuse. Des tests (menés sur des ensembles de requêtes locales) ont montré que les AI Overviews pouvaient apparaître sur une grande partie des requêtes — autour de 57% dans certains scénarios, et plus dans d’autres. Ce n’est pas une fonctionnalité « bêta » pour quelques geeks ; c’est déjà une réalité fréquente pour vos clients potentiels.

L’IA domine particulièrement les requêtes informationnelles, celles-là même qui servaient autrefois à capturer l’utilisateur au début de son parcours d’achat.

Un trafic à haute intention exige de nouveaux vecteurs de classement

Le trafic baisse, c’est un fait. Mais le trafic qui reste vaut de l’or. C’est un trafic à haute intention, prêt à convertir. Pour capter ces survivants, les vieilles recettes ne suffisent plus. Il faut prouver à l’IA que vous êtes une entité réelle, fiable et reconnue.

1. Fortifiez votre Google Business Profile comme source de données centrale

Votre fiche Google Business Profile (GBP) n’est plus une simple vitrine. C’est une source de vérité critique pour la visibilité locale. Si ce cœur ne bat pas régulièrement, vous êtes cliniquement mort aux yeux de Google.

Catégories primaires, listes de services, horaires vérifiés

Ne soyez pas négligent. Le choix de votre catégorie primaire est crucial. Ne diluez pas votre pertinence avec des catégories secondaires inutiles juste pour « ratisser large ». L’IA déteste la confusion. Vos listes de services doivent être exhaustives et correspondre parfaitement à ce qui est écrit sur votre site. Et par pitié, vérifiez vos horaires. Une entreprise fermée au moment critique ne sert à rien à l’utilisateur, donc elle est plus facilement ignorée.

Engagement actif : avis, posts, questions

L’IA ne veut pas de fiches fantômes. Elle veut voir de la vie. Répondez aux avis. Publiez des photos. Utilisez les Google Posts. Si votre fiche est statique, le système peut en déduire que votre entreprise l’est aussi.

Le GBP comme flux de données critique et vivant

Considérez votre GBP comme un flux de données quasi temps réel. La moindre modification de service ou d’horaire doit être propagée rapidement sur votre fiche, puis sur votre site. C’est une condition clé pour être perçu comme fiable.

2. Imposez une précision technique avec le balisage Schema

Les humains lisent du texte. Les machines lisent du code. Si vous voulez que l’IA vous comprenne sans ambiguïté, vous devez parler sa langue : le balisage Schema (données structurées). C’est froid, c’est technique, et c’est indispensable.

Schema LocalBusiness et Service (et geo quand c’est pertinent)

Vous devez implémenter méticuleusement les schémas « LocalBusiness » et « Service ». Définissez précisément votre type d’entreprise. Ajoutez les propriétés utiles (adresse, zone desservie, services, horaires, etc.). Les coordonnées géographiques (latitude/longitude) peuvent aider dans certains contextes (multi-lieux, pages locales, zones limites), mais vous n’avez pas besoin d’être “au mètre près” pour exister : vous avez besoin d’être cohérent et vérifiable.

Actifs visuels avec noms de fichiers descriptifs et texte alt descriptif (sans bourrage)

L’IA veut voir pour croire. Pour apparaître dans les résultats enrichis visuellement, votre site doit fournir des images pertinentes. Mais l’IA est aveugle sans contexte : chaque image doit avoir un nom de fichier descriptif et un texte alternatif clair, utile et contextualisé — pas une bouillie de mots-clés.

Ne laissez pas traîner des « IMG_001.jpg ». C’est un suicide numérique.

JSON-LD pour une maintenance et une validation faciles

Utilisez le format JSON-LD. C’est le standard. Séparez le balisage technique du design de la page. Validez tout via les outils de test. Une erreur de structure peut suffire à rendre vos données inutilisables.

3. Atteignez l’harmonie NAP omnicanale

« Name, Address, Phone » (NAP). C’est le mantra du SEO local depuis toujours, mais l’IA est encore plus intransigeante. Elle a besoin de certitudes. La moindre divergence introduit le doute. Et pour une IA, le doute est un motif de rejet.

Le GBP comme source unique de vérité

Votre fiche GBP est votre étalon. Tout le reste du web doit s’aligner sur elle. Si votre site web dit une chose et votre GBP une autre, le système hésite. Résultat ? Il privilégiera l’entité mieux tenue, plus cohérente, plus “simple à décider”.

Outils d’audit pour une cohérence à 100%

Investissez dans des outils de surveillance. Auditez votre présence. Votre NAP doit être identique (format compris) sur votre site, vos pages locales, et les annuaires tiers (Yelp, TripAdvisor, etc.).

Éliminez les conflits qui érodent la confiance de l’entité

Chaque conflit de données est une fissure. L’autorité locale devient une discipline de gestion holistique. Soyez maniaque.

4. Exploitez le sentiment authentique des avis

Google nous bassine avec son framework E-E-A-T (Expérience, Expertise, Autorité, Fiabilité). Comment prouver cela à une machine ? Par les avis. Mais pas n’importe lesquels.

Avis au niveau des attributs pour les résumés IA

L’IA lit les avis pour en extraire des attributs. Elle cherche des phrases comme « service rapide », « personnel compétent », « ambiance géniale ». Votre stratégie ne doit plus être de quémander des étoiles, mais d’inciter vos clients à décrire pourquoi vous êtes bon. Ce sont ces signaux-là qui nourrissent les résumés.

Schéma d’avis et gestion proactive (avec prudence)

Implémentez « Review » et « AggregateRating » seulement si vous le faites proprement et conformément aux règles : les “self-serving reviews” (étoiles auto-promos sur certaines pages business) peuvent ne pas être éligibles, et mal utilisées, elles attirent les ennuis. Le vrai levier, ici, reste l’avis réel, vérifiable, et la gestion active.

L’E-E-A-T à travers des interactions utilisateurs vérifiables

Répondez aux avis, positifs comme négatifs. Une entreprise qui répond est une entreprise qui existe. C’est un signal de fiabilité que l’écosystème valorise.

5. Answer Engine Optimization + Query Fan-Out

Le SEO classique est mort. Vive l’AEO (Answer Engine Optimization). L’objectif n’est plus seulement de placer des mots-clés, mais de fournir des réponses structurées que l’IA peut extraire facilement.

Cartographiez les questions latentes au-delà des requêtes principales

L’IA anticipe. Elle utilise le « Query Fan-Out » pour prédire les questions suivantes. Votre contenu doit répondre à la question A, mais aussi aux questions B et C qui en découlent.

Structure « Answer-first » : titres, FAQ, listes

Facilitez la vie de l’IA : titres hiérarchisés, FAQ structurées, listes à puces, paragraphes courts. Si votre contenu est un pavé indigeste, l’IA passera son chemin.

Double stratégie : AEO informationnel + CRO transactionnel

D’un côté, du contenu informationnel optimisé pour être cité (guides, FAQ). De l’autre, des pages transactionnelles hyper-locales conçues pour convertir immédiatement le trafic qui survit.

6. Diversifiez l’autorité de l’entité avec les mentions de marque

Les liens (backlinks) ne disparaissent pas, mais ils ne sont plus l’unique religion. L’IA accorde une importance croissante à la cohérence, à la réputation, aux mentions et à la présence de marque — liées ou non.

Citations non liées vs liens de faible valeur

Une mention de votre marque dans un journal local ou un blog respecté vaut souvent mieux que dix liens spammy. Cherchez la confirmation “sociale” de votre existence.

Réseaux sociaux, YouTube et actus locales pour les signaux d’entité

L’IA scanne des sources multiples. Une vidéo qui parle de vous, une discussion, un article local : tout cela compte. Ne négligez aucun canal.
SEO Local

Arrêtez d’acheter des liens. Faites des relations publiques. Créez des histoires. Soyez cité. La marque devient une forme de lien.

7. Optimisez pour des conversions à haute vélocité

Acceptez-le : vous aurez moins de visiteurs. Mais ceux qui arrivent peuvent être plus proches de l’achat.

CTA au-dessus de la ligne de flottaison pour le trafic bas de tunnel

L’utilisateur qui sort de l’AI Mode a déjà eu des réponses. Il veut agir. Mettez vos CTA immédiatement : « Réserver », « Appeler », « Devis ».

Friction minimale pour les visiteurs qualifiés

Réduisez les formulaires. Simplifiez la navigation. Si l’utilisateur doit chercher comment vous payer, il repart.

Recalibrez les KPI sur les conversions, pas les clics

Regardez les ventes, les appels, les demandes. La visibilité IA ne se mesure pas toujours en clics.

8. Assurez l’avenir avec l’accessibilité du contenu

L’IA est vorace, mais elle reste dépendante de ce qu’elle peut lire et interpréter correctement.

Évitez de cacher les faits critiques derrière du JS lourd

Ce n’est pas “tabs/accordions = mal” par principe : si c’est accessible, c’est souvent indexable. Le danger, c’est quand les faits critiques sont derrière des interactions difficiles à rendre (JS lourd, chargement conditionnel) ou quand l’essentiel n’apparaît pas clairement.

HTML simple pour les faits critiques

Pour les machines, le HTML propre reste roi. Assurez-vous que vos infos clés (services, zones, prix indicatifs, certifications, délais, garanties) sont lisibles et compréhensibles.

Outils d’audit LLM pour la découverte de faits

Utilisez des audits pour vérifier quelles questions votre site permet de résoudre et quels faits sont réellement détectables. Si l’IA ne trouve pas vos faits, c’est comme s’ils n’existaient pas.

Le mandat génératif pour le succès du SEO local

Nous y voilà. L’ère du « mot-clé roi » est morte et enterrée. Nous entrons dans l’ère de l’autorité de l’entité. Google AI Mode ne vous laisse pas le choix : adaptez-vous ou disparaissez.

Ce n’est pas un débat philosophique, c’est une urgence commerciale. Le pivot stratégique doit être immédiat. Vous ne pouvez plus vous contenter de « faire du SEO ». Vous devez structurer votre entreprise pour qu’elle devienne une source de faits irréprochable pour une intelligence artificielle affamée.

Votre survie dépend de quatre piliers : conformité technique, intégrité des données, raffinement du contenu par l’AEO, et omniprésence de la marque. Le trafic de masse est fini. La bataille pour le trafic de haute qualité ne fait que commencer. Êtes-vous prêt à vous battre pour exister dans la machine ?
Cybersécurité 2026 : L’IA, le quantique et la fin de l’innocence numérique

L’utopie numérique a vécu. Nous pensions bâtir une bibliothèque d’Alexandrie universelle, un espace de liberté et de savoir partagé. À la place, nous avons construit un colisée où des algorithmes gladiateurs s’entretuent sous le regard impuissant de leurs créateurs. En 2026, la cybersécurité n’est plus une simple discipline technique ; c’est une guerre de tranchées permanente, invisible et silencieuse, qui se joue sur les serveurs de nos entreprises et dans les méandres de nos vies privées.

Regardons la vérité en face : nous avons perdu le contrôle. La complexité de nos systèmes a dépassé notre capacité à les sécuriser. Chaque nouvelle connexion, chaque « objet intelligent », chaque ligne de code est une porte ouverte que nous ne savons plus fermer. Le paysage des menaces de 2026 ne ressemble à rien de ce que nous avons connu. Il est piloté par une intelligence artificielle qui apprend plus vite que nous, menacé par une puissance de calcul quantique capable de briser nos serrures les plus solides, et miné par une chaîne logistique dont nous ignorons les maillons faibles.

Cet article n’est pas un guide de survie optimiste. C’est un constat lucide, peut-être amer, des tendances qui façonneront la protection des informations en 2026. Préparez-vous à douter de tout, surtout de la sécurité de vos propres écrans.

L’IA et le Machine Learning pour la Cyberdéfense : Le serpent qui se mord la queue

L’intelligence artificielle est devenue la tarte à la crème des discours corporatistes. On nous la vend comme le remède miracle, le bouclier ultime capable d’analyser des milliards de données pour repérer l’aiguille dans la botte de foin numérique. Et c’est vrai, en partie. En 2026, aucune défense sérieuse ne peut se passer de l’IA.

Les outils de défense basés sur le Machine Learning (ML) sont désormais capables de :

  • Analyser des comportements en temps réel : Ils ne cherchent plus des signatures de virus connus, mais des anomalies, des déviations subtiles dans le trafic réseau qui trahissent une intrusion.
  • Automatiser la réponse : Avant même qu’un analyste humain n’ait fini son café, l’IA a déjà isolé un terminal compromis.
  • Prédire les vecteurs d’attaque : En ingérant des quantités phénoménales de données sur les menaces mondiales, l’IA tente de deviner où la foudre va tomber.

Mais ne soyons pas dupes. Cette technologie est une arme à double tranchant, et le manche est glissant. Car si nous utilisons l’IA pour nous défendre, nos adversaires l’utilisent pour attaquer avec une efficacité redoutable. C’est une course aux armements, absurde et frénétique.

Les attaquants utilisent désormais l’IA pour :

  • Automatiser le phishing : Fini les emails bourrés de fautes d’orthographe. Les LLM (Large Language Models) génèrent des messages de harponnage (spear-phishing) personnalisés, contextuels et indiscernables d’une communication légitime.
  • Développer des malwares polymorphes : Des virus qui réécrivent leur propre code à la volée pour échapper à la détection des… IA de défense.
  • Découvrir des vulnérabilités « Zero-Day » : L’IA scanne le code plus vite que n’importe quel humain pour trouver la faille non patchée.

Nous sommes entrés dans l’ère de la guerre « machine contre machine ». L’humain n’est plus qu’un spectateur, ou pire, le maillon faible qui clique sur le mauvais lien.

Informatique quantique et chiffrement post-quantique : L’épée de Damoclès

Si l’IA est le danger immédiat, l’ordinateur quantique est l’apocalypse annoncée. Pendant des décennies, nous avons reposé notre sécurité sur une hypothèse mathématique simple : il est difficile pour un ordinateur classique de factoriser de grands nombres entiers. C’est la base du chiffrement RSA, qui protège tout, de vos transactions bancaires à vos secrets d’État.

L’informatique quantique promet de pulvériser cette difficulté en quelques secondes.

Certes, l’ordinateur quantique capable de casser le RSA n’est peut-être pas encore dans tous les garages en 2026. Mais la menace est déjà là, insidieuse, sous la forme du « Harvest Now, Decrypt Later » (Récolter maintenant, déchiffrer plus tard). Les agences de renseignement et les groupes criminels stockent dès aujourd’hui des téraoctets de données chiffrées, attendant patiemment le jour où la technologie permettra de les ouvrir comme des boîtes de conserve.

Face à ce mur, le NIST (National Institute of Standards and Technology) tente de colmater les brèches avec de nouveaux standards de cryptographie post-quantique (PQC), finalisés en août 2024. Il s’agit d’une tentative désespérée de changer les serrures avant que les cambrioleurs n’aient la clé universelle.

Les entreprises doivent dès maintenant se tourner vers ces algorithmes résistants :

  • ML-KEM (FIPS 203) : Pour l’établissement de clés, basé sur les réseaux euclidiens.
  • ML-DSA (FIPS 204) et SLH-DSA (FIPS 205) : Pour les signatures numériques.

La transition sera longue, coûteuse et douloureuse. Elle demandera de revoir l’architecture de sécurité de fond en comble. Ceux qui pensent avoir le temps se bercent d’illusions. L’horloge tourne, et elle tourne vite.

Expansion de l’architecture Zero Trust : L’aveu d’échec de la confiance

Le concept de « Zero Trust » (Zéro Confiance) est fascinant. Sous son nom marketing accrocheur se cache une philosophie profondément cynique : ne faites confiance à personne, jamais. Ni à vos employés, ni à vos appareils, ni à votre réseau interne. C’est l’officialisation de la paranoïa comme stratégie de survie.

En 2026, le Zero Trust n’est plus une option, c’est la norme. L’idée même d’un « périmètre de sécurité » (le château fort avec ses douves) est morte et enterrée. Avec le télétravail, le cloud et la mobilité, le périmètre est partout et nulle part.

Selon le NIST SP 800-207, les piliers de cette méfiance institutionnalisée sont clairs :

  • Vérification continue : Ce n’est pas parce que vous avez entré votre mot de passe à 9h00 que vous êtes toujours légitime à 9h05. Chaque requête est suspecte.
  • Moindre privilège : On ne vous donne accès qu’au strict minimum nécessaire pour travailler. Comme dans une prison, les portes ne s’ouvrent que si c’est indispensable.
  • Micro-segmentation : Le réseau est découpé en minuscules îlots étanches pour empêcher un attaquant de se déplacer latéralement.

C’est une approche nécessaire, certes. Mais qu’est-ce que cela dit de notre société numérique ? Que la trahison est l’état par défaut. Que l’utilisateur est coupable jusqu’à preuve du contraire. Nous avons construit un monde où la fluidité promise se heurte désormais à des murs de vérification perpétuelle.

Focus accru sur la sécurité de la chaîne d’approvisionnement : Le talon d’Achille

Vous pouvez avoir la meilleure forteresse du monde, si le livreur de pizza a les clés et qu’il est malade, vous serez contaminé. C’est le principe de la sécurité de la chaîne d’approvisionnement (Supply Chain Security). Les entreprises ont externalisé, sous-traité, et empilé les logiciels tiers pour gagner en « agilité ». Résultat ? Elles ont multiplié les surfaces d’attaque par mille.

L’attaque SolarWinds reste le spectre qui hante nos mémoires, la preuve que l’on peut infecter des milliers d’organisations en empoisonnant une seule mise à jour logicielle. En 2026, la méfiance envers les fournisseurs atteint des sommets.

Sous l’impulsion de directives comme l’Executive Order 14028 aux États-Unis, la transparence n’est plus une courtoisie, c’est une exigence vitale :

  • SBOM (Software Bill of Materials) : C’est la liste des ingrédients de votre logiciel. Vous ne mangeriez pas un plat industriel sans regarder l’étiquette, n’est-ce pas ? Les entreprises exigent désormais de savoir exactement quelles librairies open-source (souvent maintenues par un bénévole épuisé dans un sous-sol) composent leurs outils critiques.
  • Sécurité dès la conception (Secure by Design) : On demande aux éditeurs de livrer des produits sécurisés par défaut, plutôt que de vendre des passoires et de facturer les rustines. Un vœu pieux ? Peut-être, mais la pression régulatoire s’accentue.

Nous réalisons tardivement que notre infrastructure numérique repose sur un château de cartes d’interdépendances fragiles. Un seul fournisseur compromis, et c’est tout l’écosystème qui s’effondre.

Stratégies renforcées de défense et de récupération contre les ransomwares

Le ransomware est devenu le business model le plus rentable du 21ème siècle, loin devant bien des start-ups de la Silicon Valley. C’est le capitalisme sauvage appliqué au crime : offre, demande, extorsion. En 2026, les gangs de ransomwares ne se contentent plus de chiffrer vos données. Ils pratiquent la « double », voire la « triple » extorsion.

Le scénario est tristement banale :

  1. Ils volent vos données sensibles.
  2. Ils chiffrent vos serveurs.
  3. Ils menacent de publier les données volées si vous ne payez pas.
  4. Ils harcèlent vos clients et partenaires pour qu’ils fassent pression sur vous.

Les statistiques sont accablantes. Le rapport IC3 du FBI montrait déjà en 2024 des milliers de plaintes et des pertes se chiffrant en millions, et ce n’est que la partie émergée de l’iceberg, car beaucoup paient en silence, la honte au front.

Face à cela, la défense s’organise, non pas pour gagner, mais pour survivre :

  • Assurance cyber : Devenue hors de prix et pleine d’exclusions, elle reste un parachute indispensable.
  • Immuabilité des sauvegardes : Des backups que même l’administrateur ne peut pas modifier ou effacer, pour espérer repartir de zéro après le chaos.
  • Exercices de crise : On ne se demande plus « si » on sera attaqué, mais « quand ». Les entreprises répètent leur propre fin du monde pour espérer limiter la casse.

C’est une guerre d’usure psychologique autant que technique. Payer finance le crime, ne pas payer peut signifier la faillite. Cornélien, n’est-ce pas ?

cybersécurité en 2026

Défis de sécurité de l’IoT et de la 5G : La toile d’araignée infinie

Pourquoi avons-nous besoin que notre réfrigérateur soit connecté à Internet ? Ou que notre voiture envoie des données en temps réel à un constructeur à l’autre bout du monde ? Nous avons embrassé l’Internet des Objets (IoT) et la 5G avec l’enthousiasme naïf d’un enfant trouvant une grenade dégoupillée.

En 2026, la surface d’attaque est devenue grotesque.

  • L’IoT : Des milliards d’appareils, souvent conçus avec une sécurité inexistante (mots de passe par défaut, pas de mises à jour possibles), sont autant de portes d’entrée dans les réseaux domestiques et d’entreprise. Ce sont des zombies dormants, prêts à être enrôlés dans des botnets massifs pour lancer des attaques DDoS.
  • La 5G : Elle offre une vitesse fulgurante et une latence nulle, parfait pour connecter encore plus d’objets vulnérables encore plus vite. Elle décentralise le réseau, multipliant les points d’entrée physiques difficiles à surveiller.
  • Les véhicules connectés : Votre voiture est désormais un ordinateur sur roues. Et comme tout ordinateur, elle peut être piratée. Imaginez les conséquences d’un ransomware sur une flotte de camions autonomes lancés sur l’autoroute.

Nous avons sacrifié la sécurité sur l’autel de la commodité. Nous vivons dans une maison de verre où chaque ampoule connectée est un mouchard potentiel.

Technologies d’amélioration de la confidentialité (PETs) : Le dernier masque

Dans ce monde où la vie privée semble être un concept du passé, une relique pittoresque du 20ème siècle, les Technologies d’Amélioration de la Confidentialité (PETs – Privacy-Enhancing Technologies) apparaissent comme le dernier rempart. Ou peut-être la dernière illusion.

Ces technologies, comme le chiffrement homomorphe ou le calcul multipartite sécurisé, promettent le beurre et l’argent du beurre : permettre aux entreprises d’analyser nos données, de les utiliser pour entraîner leurs IA voraces, sans jamais avoir accès aux données brutes elles-mêmes. C’est la promesse de pouvoir traiter des données chiffrées sans les déchiffrer.

L’adoption des PETs s’accélère en 2026, poussée par :

  • La régulation : Des lois toujours plus strictes (inspirées du GDPR) qui forcent la main aux collecteurs de données.
  • La méfiance des consommateurs : Qui commencent, peut-être trop tard, à réaliser que leurs données sont le nouvel or noir.

Cependant, ne nous y trompons pas. Les PETs sont des pansements techniques sur une hémorragie éthique. Elles permettent de continuer le « business as usual » du capitalisme de surveillance, en y apposant un tampon « respectueux de la vie privée ». C’est mieux que rien, dira-t-on. C’est surtout la preuve que nous avons renoncé à l’idée de ne pas collecter la donnée, pour se concentrer uniquement sur la manière de la sécuriser pendant son exploitation.

Le réveil difficile

Alors, que retenir de ce panorama de 2026 ? Que la technologie ne nous sauvera pas d’elle-même. Chaque solution apporte son lot de nouveaux problèmes. L’IA nous protège et nous attaque. Le quantique nous promet des calculs inouïs et menace nos secrets. La connectivité totale nous offre le confort et la vulnérabilité absolue.

La cybersécurité n’est plus une question informatique. C’est une question existentielle pour nos sociétés. Tant que nous privilégierons la vitesse sur la sécurité, le profit sur la résilience, et la connexion sur la réflexion, nous continuerons à courir après notre propre ombre.

Dormez bien, et n’oubliez pas de faire vos mises à jour. Même si, au fond, cela ne suffira probablement pas.